Project · AI 应用 · 开发中
亲历(firsthand):让模拟用户真实使用产品,再给出带证据的体验报告
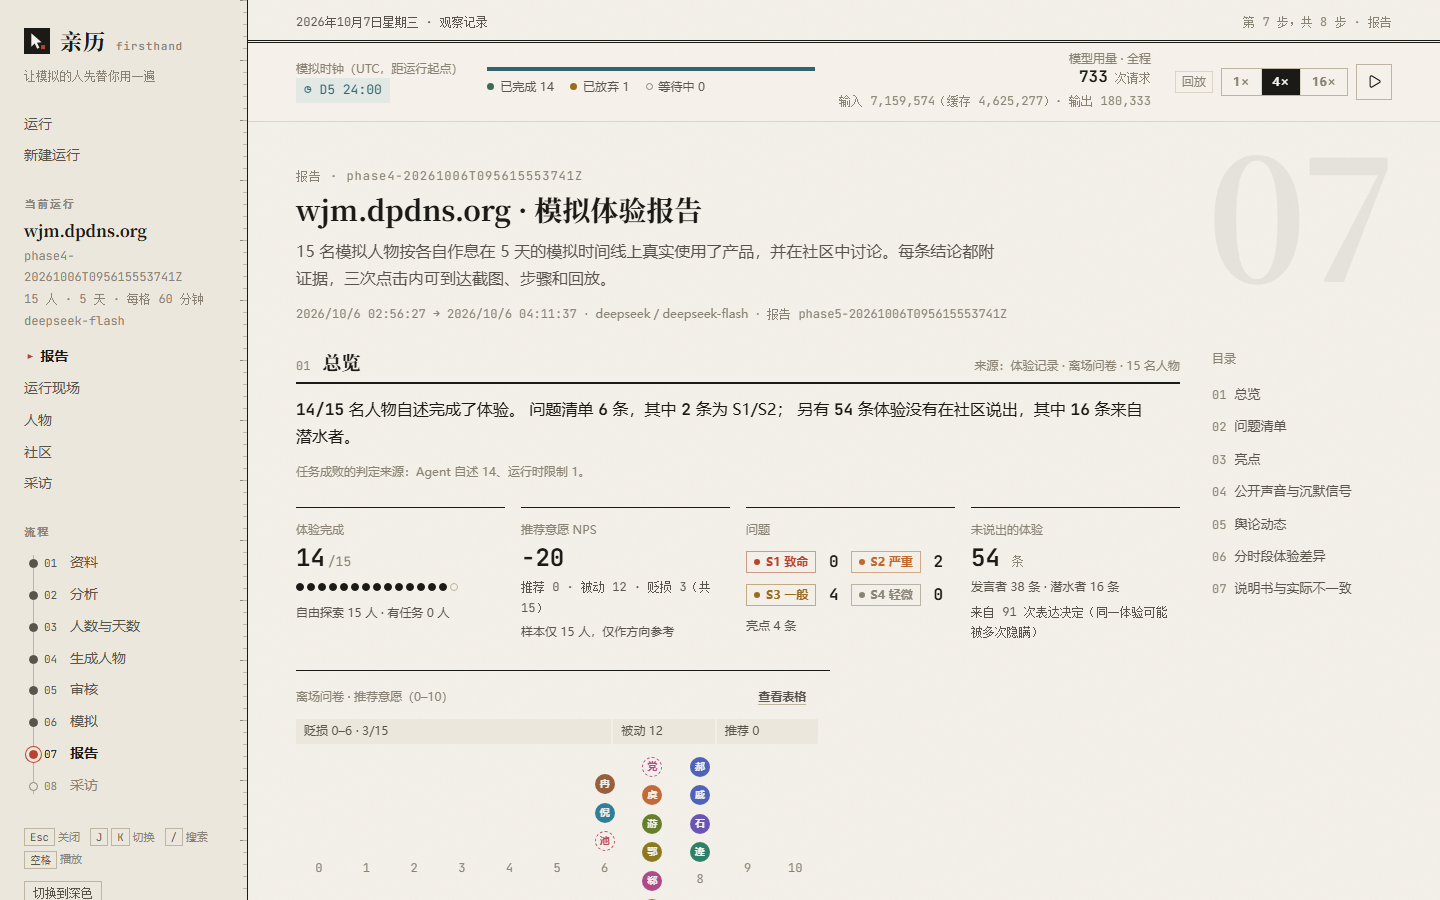
面向产品作者的体验测试工具。你提供自己产品的网址和使用说明,主 Agent 生成一批带完整背景与作息的虚拟用户,他们在云端浏览器里真实操作产品,并在模拟社区里讨论。最终报告的每条结论都能追溯到截图、录像或原话,并区分“说出来的”和“体验了但没说的”。
它解决什么问题
用大模型“想象”用户反馈很容易,但想象出来的意见没有依据。亲历的做法相反:虚拟用户必须先亲手用过产品,才有资格发言。没有体验过的人只能看帖,不能发帖。
它面向有自己产品的人,测试对象仅限自己的产品,需要有可深度操作的测试账号。
工作流程
输入:一份使用说明书,最少只需要产品网址和允许访问的域名。资料不足时,系统会提示结果的参考性有限。
主 Agent 解析说明书,推荐人数(一般 30–50 人)和模拟天数,用户确认或修改后再生成人物。
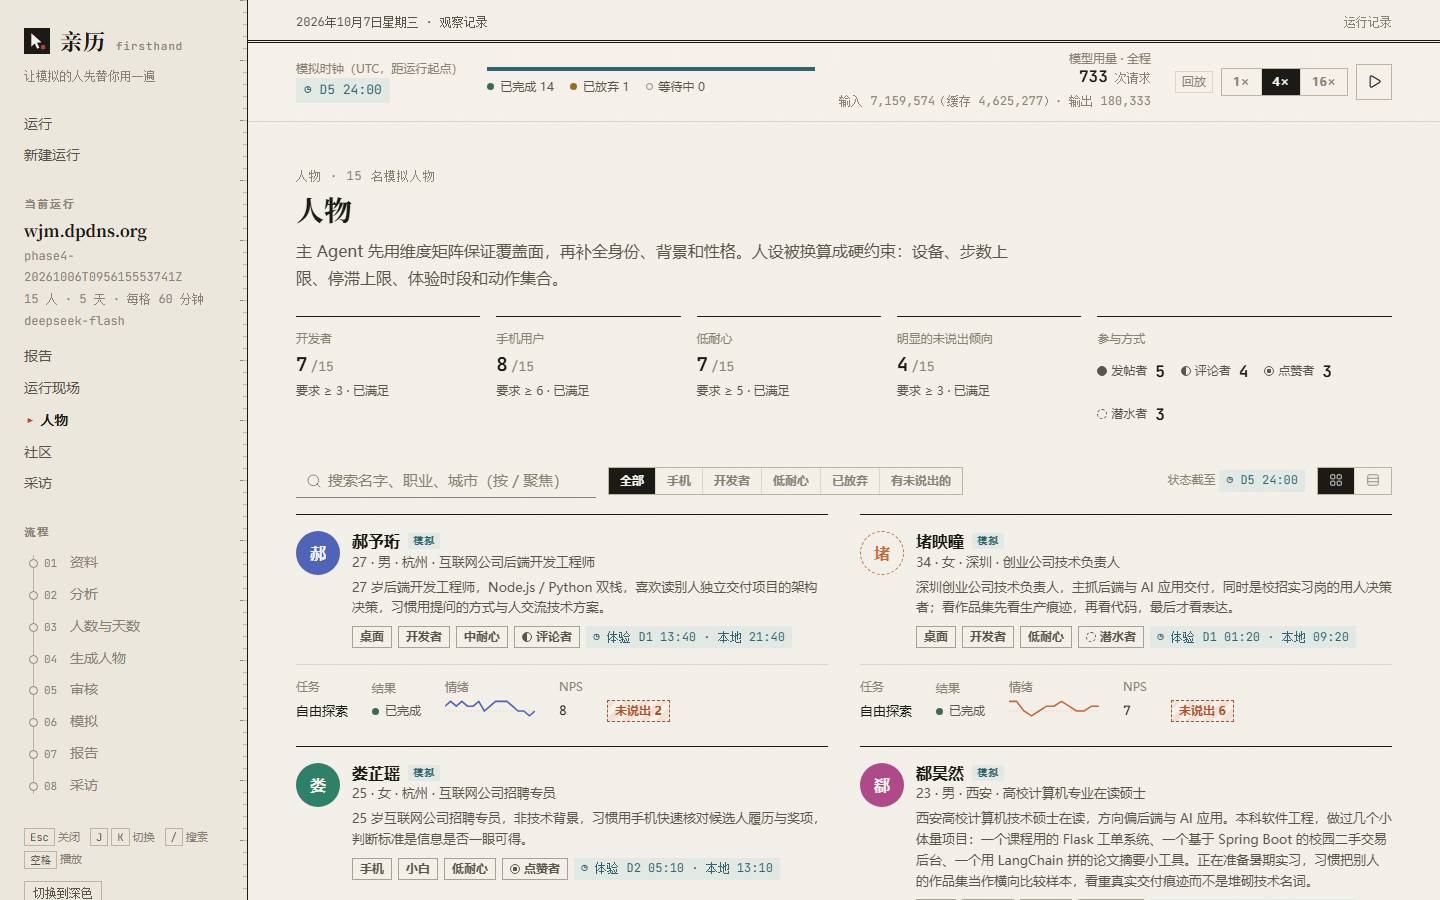
每个人物有身份、背景、性格和作息,也有由性格推出的采样参数。人物草稿经人工审核后才进入执行。
人物在各自的时段里通过 Browser Use 驱动云端浏览器使用产品,每人一个独立会话并自带录像。
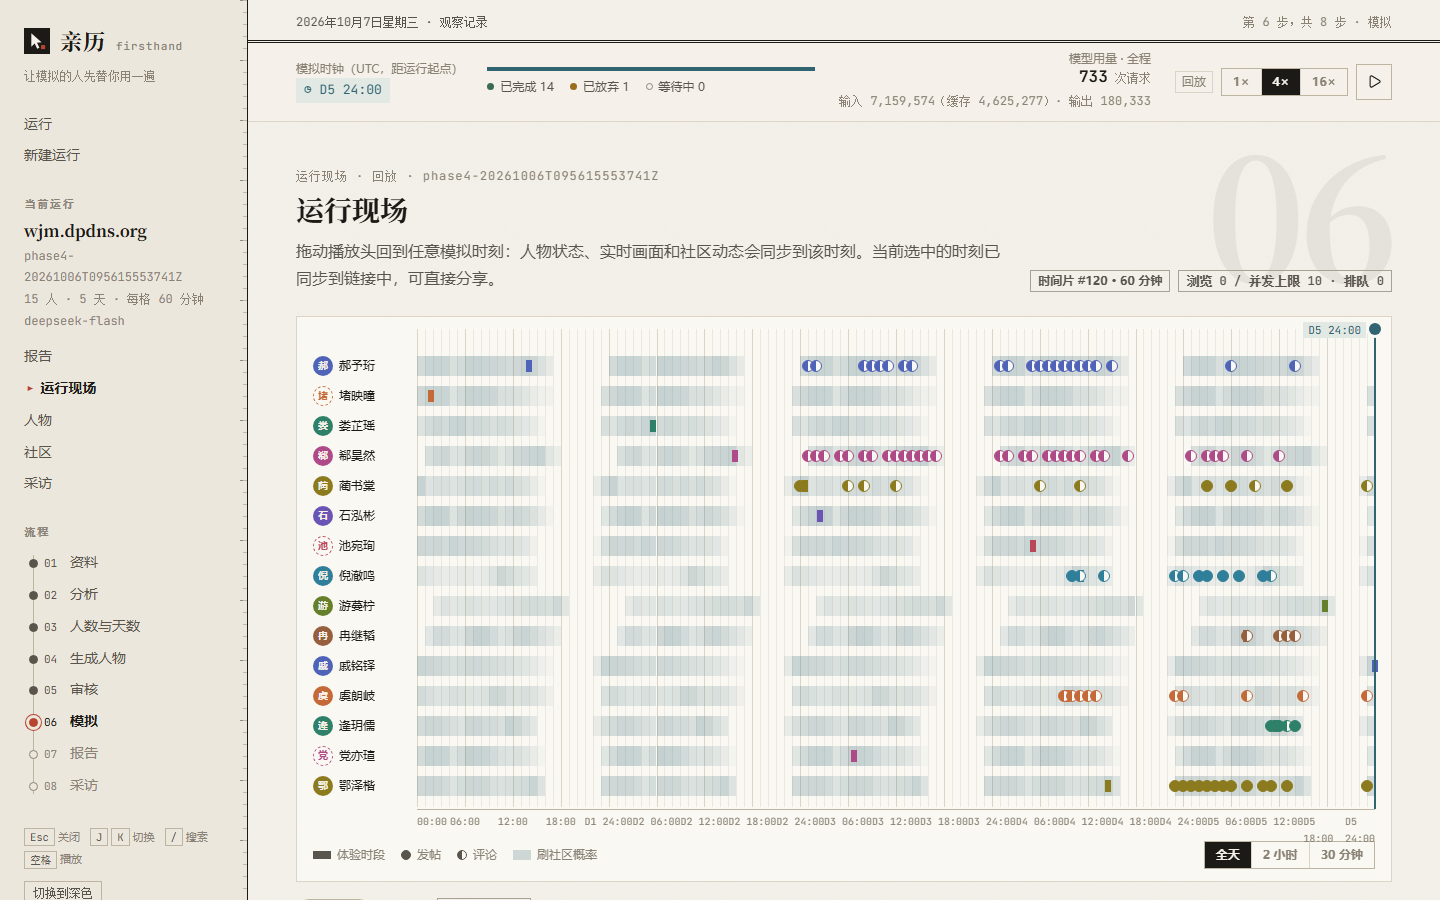
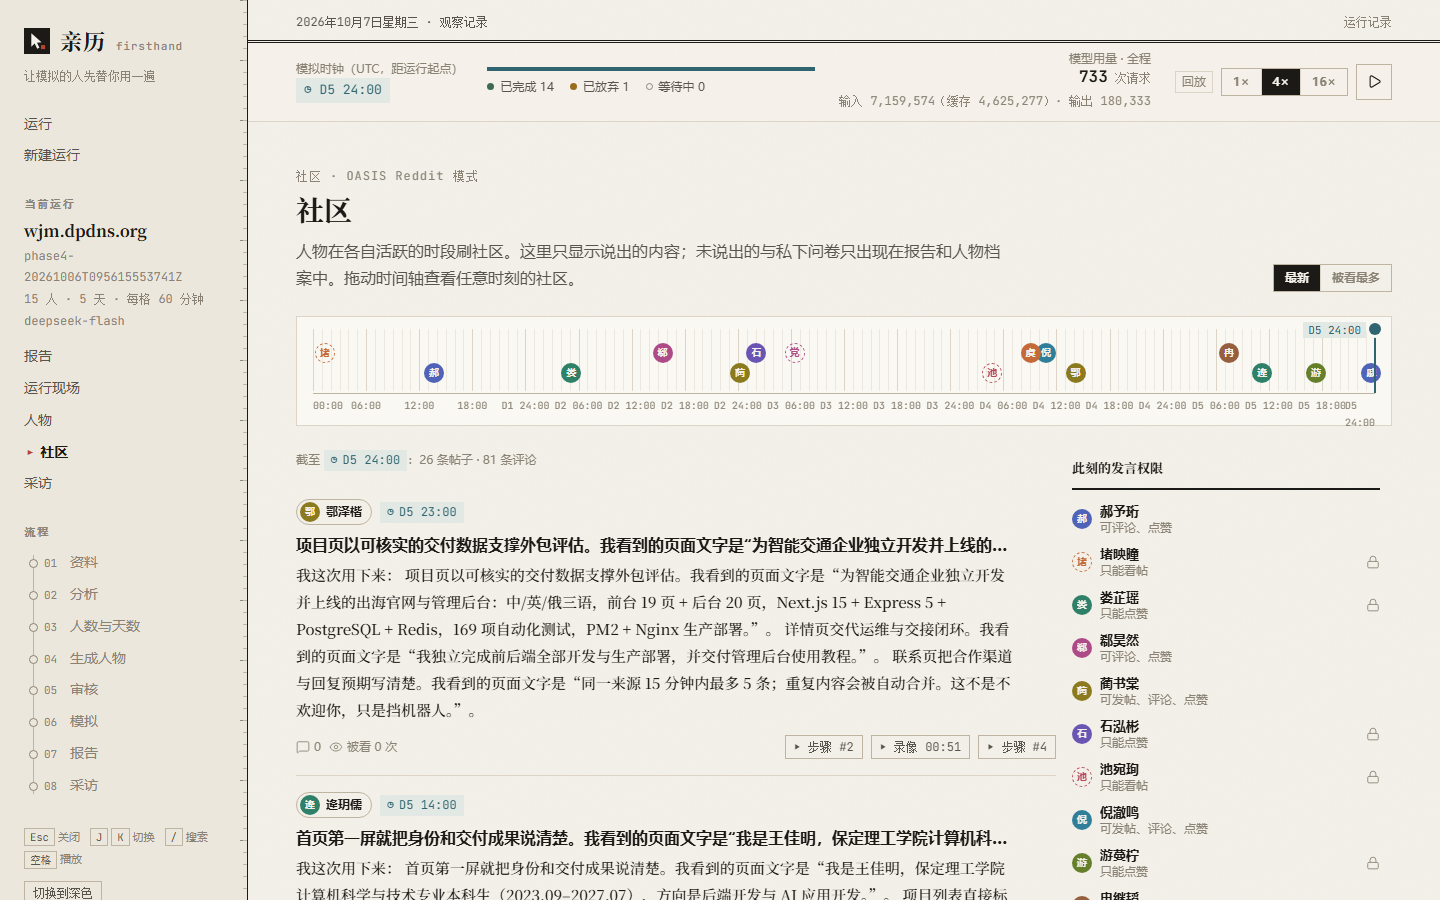
体验之外,他们还在 OASIS 的 Reddit 模式社区里讨论:有人发帖,有人只评论,有人只点赞,有人潜水。
Report Agent 读取运行记录,生成报告。
几个设计取舍
观察权限分级:底层采集全部数据,但每个人物只能看到自己权限内的那部分。
说出来的和没说的分开呈现:有人体验后会隐瞒部分感受,报告把这部分单独列出。
证据门禁:问题清单与亮点由模型撰写,但引用必须存在、引文必须是原文、类型必须匹配,正文点名的人必须引用其同类型结论,只有通过的结论才计入影响人数。其余章节由代码从完整记录直接生成。
模型能力以实测为准:不相信模型的自我声明,启动前探测是否支持工具调用和识图。不支持识图的纯文本模型也能运行,但浏览时只读页面文字和结构,运行列表、审核页和报告都会标注参考性有限。
并发共享额度:模型请求和浏览会话的并发额度,通过操作系统文件锁在多个进程间共享。
界面
前端可以只填网址新建运行,经过说明书校验、人物草稿、审核、模拟与报告几个步骤,并查看进度。报告里的问题可以在页内播放对应的浏览录像,并定位到所引用的截图,证据附 Console 和 Network 摘要。完成后还能对虚拟用户做采访,采访的用量单独记账。
技术栈
后端是 Python,接口层用 FastAPI,只读展示运行结果,并通过子进程执行命令行模块。浏览和讨论分别运行在两个独立的 Python 环境里,各自依赖 Browser Use 与 OASIS。前端是 Vue 3 + Vite。模型通过适配器接入,目前有通用 OpenAI 兼容、DeepSeek、MiMo 三种,统一从 config/.env 配置。接口只接受本机 Host,防止 DNS 重绑定读取运行数据。
当前状态
项目在 2026 年 10 月初完成了阶段 0 到阶段 8,共 50 次提交,目前仍在自用迭代,近期的改动集中在界面改版和命名(原名后改为“亲历”)。真实样本已经跑通 10 人浏览、讨论、问卷和报告的完整链路。代码暂未公开。